وبلاگ
 هر قسط 54.750 تومانهر قسط 54.750 تومان•خرید قسطی با تربپی بدون کارمزد
“تسلط به برنامهنویسی پایتون با هوش مصنوعی: آموزش کدنویسی هوشمند با ChatGPT”
"تسلط به برنامهنویسی پایتون با هوش مصنوعی: آموزش کدنویسی هوشمند با ChatGPT"
"با شرکت در این دوره جامع و کاربردی، به راحتی مهارتهای برنامهنویسی پایتون را از سطح مبتدی تا پیشرفته با کمک هوش مصنوعی ChatGPT بیاموزید. این دوره، با بیش از 6 ساعت محتوای آموزشی، شما را قادر میسازد تا به سرعت الگوریتمهای پیچیده را درک کرده و اپلیکیشنهای هوشمند ایجاد کنید. مناسب برای تمامی سطوح با زیرنویس فارسی حرفهای و امکان دانلود و تماشای آنلاین."
ویژگیهای کلیدی:
بدون نیاز به تجربه قبلی برنامهنویسی
زیرنویس فارسی با ترجمه حرفهای
۳۰ ٪ تخفیف ویژه برای دانشجویان و دانش آموزان
هر قسط 87.250 تومانهر قسط 87.250 تومان•خرید قسطی با تربپی بدون کارمزد  هر قسط 124.750 تومانهر قسط 124.750 تومان•خرید قسطی با تربپی بدون کارمزد
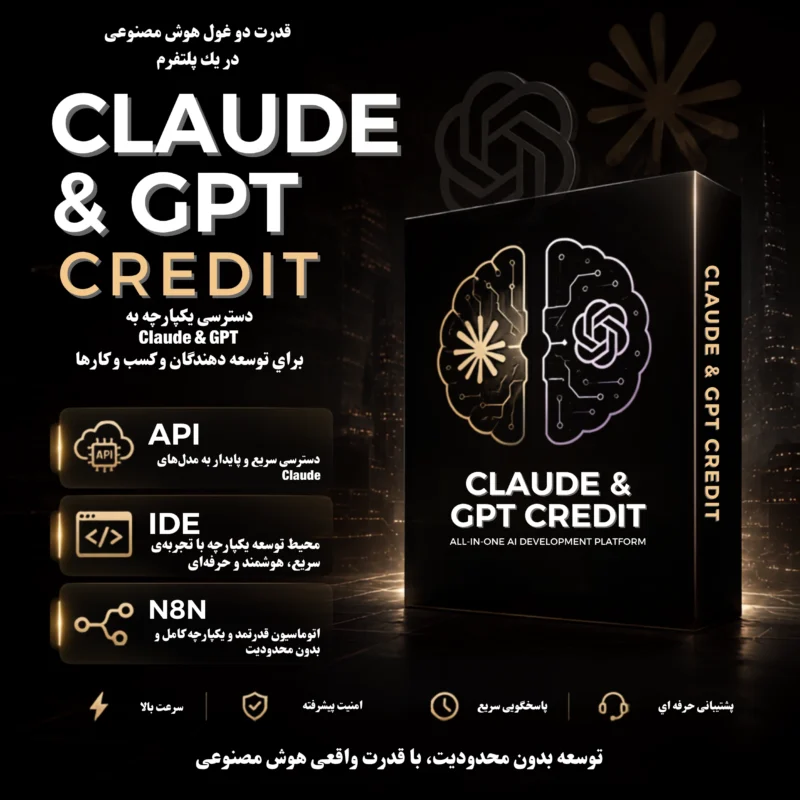
Claude & GPT Credit – API | IDE | n8n
میتوانید به کمک این کارت اپلیکیشن ها، سایت ها، رباتها و ورکفلوهای N8N خود را به تمام مدل های Claude , GPT به طور همزمان متصل کنیدو از این مدل های قدرتمند استفاده نمایید.
همچنین کارت شما قابلیت شارژ مجدد و افزایش کردیت دارد. (روی همان کارت شخصی خودتان)
همراه با آموزش اضافه کردن در n8n، VScode، Antigravity، Cursor و...
 هر قسط 749.750 تومانهر قسط 749.750 تومان•خرید قسطی با تربپی بدون کارمزد
 هر قسط 244.750 تومانهر قسط 244.750 تومان•خرید قسطی با تربپی بدون کارمزد
 هر قسط 87.250 تومانهر قسط 87.250 تومان•خرید قسطی با تربپی بدون کارمزد
 هر قسط 124.750 تومانهر قسط 124.750 تومان•خرید قسطی با تربپی بدون کارمزد
 هر قسط 74.750 تومانهر قسط 74.750 تومان•خرید قسطی با تربپی بدون کارمزد
 هر قسط 124.750 تومانهر قسط 124.750 تومان•خرید قسطی با تربپی بدون کارمزد
 هر قسط 117.250 تومانهر قسط 117.250 تومان•خرید قسطی با تربپی بدون کارمزد
دوره فوق فشرده مکالمه زبان انگلیسی (ویژه بزرگسالان)
دوره آموزش مکالمه فوق فشرده زبان انگلیسی در 100 قسمت ویدئویی، شامل 6 ترم یکماهه با پیوستگی کامل مطالب: ترم 1 (Elementary)، ترم 2 (Intermediate)، ترم 3 (Advance)، ترم 4 (Professional)، ترم 5 (Fluent speaking)، ترم 6 (Native Speaker). بهترین فرصت برای یادگیری زبان انگلیسی به صورت حرفهای و روان. در حامی صنعت بیاموزید!
هر قسط 500.000 تومانهر قسط 500.000 تومان•خرید قسطی با تربپی بدون کارمزد 
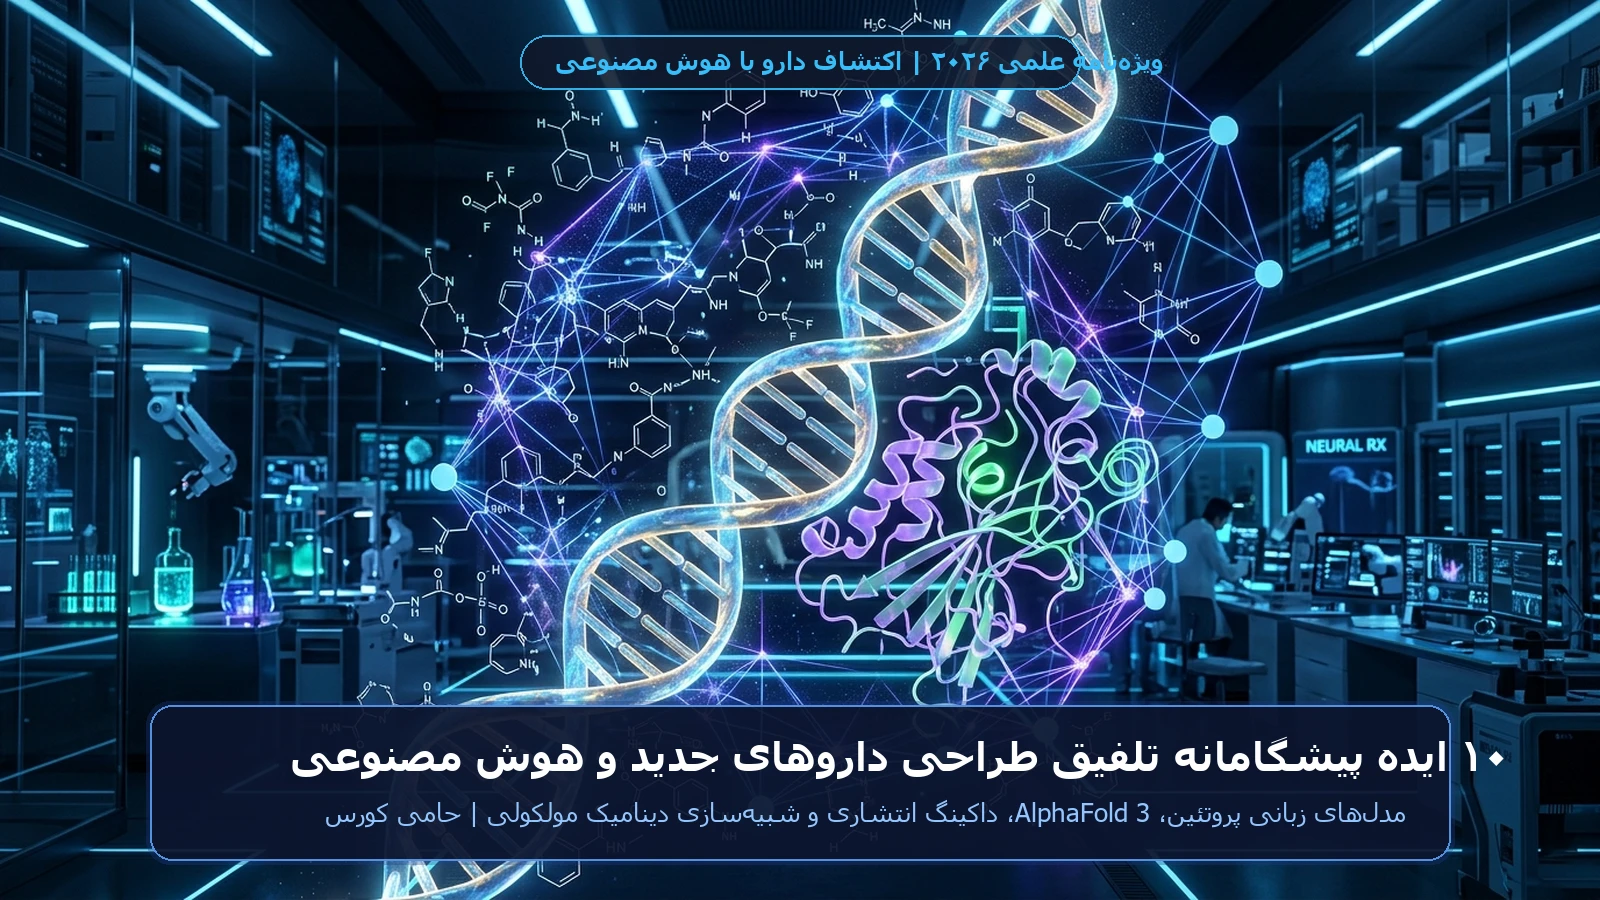
صنعت داروسازی در سال ۲۰۲۶ در نقطه عطف تاریخی بیسابقهای ایستاده است. برای دههها، فرآیند کشف و توسعه یک داروی جدید شبیه به جستجوی سوزن در انبار کاهی کیهانی بود؛ فرآیندی فرسایشی که به طور میانگین بین ۱۰ تا ۱۵ سال زمان میبرد، هزینهای سرسامآور بالغ بر ۲.۶ میلیارد دلار به شرکتهای داروسازی تحمیل میکرد و در نهایت با نرخ شکست تکاندهنده بیش از ۹۰ درصد در کارآزماییهای بالینی مواجه میشد. این پدیده که در ادبیات اقتصاد دارویی به «قانون Eroom» (معکوس قانون مور، یعنی کاهش مداوم بهرهوری داروسازی با وجود رشد هزینهها) شهرت یافته بود، سرانجام با بلوغ انقلاب هوش مصنوعی زایشی (Generative AI)، مدلهای بیومولکولی بنیادین و یادگیری عمیق ساختاری در هم شکسته شد.
امروزه در سال ۲۰۲۶، دیگر دانشمندان برای کشف مهارکنندهها یا آگونیستهای بیولوژیکی به غربالگری تصادفی میلیونها ترکیب در کتابخانههای شیمیایی سنتی تکیه نمیکنند. ادغام مدلهای انتشار متقارن ۳بعدی (Equivariant 3D Diffusion)، مدلهای زبانی پروتئین نظیر ESM-3، ساختارهای فرامولکولی همهجانبه AlphaFold 3 و محاسبات شبیهسازی دینامیک مولکولی مبتنی بر پتانسیلهای یادگیری ماشین، مسیر کشف دارو را از یک فرآیند مبتنی بر «سعی و خطای تجربی» به یک علم «محاسباتی و مهندسیپذیر» بدل ساخته است. هدف دیگر صرفاً پیدا کردن یک مولکول نیست؛ بلکه طراحی دونوو (De Novo Design) و مهندسی اتم به اتم ساختارهایی است که به طور همزمان بیشترین میل پیوندی به پاکت هدف، کمترین سمیت سلولی، بهترین نفوذپذیری زیستی و بالاترین قابلیت سنتز شیمیایی را دارا باشند.
💡 تغییر جهت استراتژیک در سال ۲۰۲۶: از CADD سنتی به AIDD هوشمند
در حالی که طراحی داروی به کمک کامپیوتر سنتی (CADD) سالها بر داکینگ صلب و شبیهسازیهای کلاسیک مبتنی بر میدانهای نیرو متکی بود، طراحی دارو با هوش مصنوعی نوین (AIDD) وارد قلمرو «شبیهسازی زایشی و فعال چندهدفه» شده است. هوش مصنوعی دیگر یک فیلتر پسپردازش نیست، بلکه موتور مولد فرضیههای شیمیایی و اعتبارسنجی زودهنگام در کسری از ثانیه است.
فهرست مطالب جامع مقاله
- ۱. مقایسه متدولوژی سنتی کشف دارو در برابر طراحی دارو با هوش مصنوعی ۲۰۲۶
- ۲. ایده ۱: طراحی دونوو مولکولهای کوچک با مدلهای انتشار ۳بعدی Target-Aware Diffusion
- ۳. ایده ۲: پیشبینی دقیق برهمکنشهای چندگانه با AlphaFold 3 و کمپلکسهای اتمی
- ۴. ایده ۳: توسعه داروهای تخریبگر هدفمند (PROTACs و Molecular Glues) با شبکههای عصبی گراف
- ۵. ایده ۴: مدلهای زبانی شیمیایی (Chemical LLMs) و آزمایشگاههای شیمی خودران رباتیک
- ۶. ایده ۵: هدفگیری ساختارهای سهبعدی RNAهای غیرکدکننده (RNA-Targeting) با یادگیری عمیق
- ۷. ایده ۶: پیشبینی چندوظیفهای خواص فارماکوکینتیک و پروفایل سمیت (ADMET Transfer Learning)
- ۸. ایده ۷: طراحی واکسنهای نئورآنتیژن شخصیسازیشده و آنتیبادیهای درمانی با Protein LLMs
- ۹. ایده ۸: شبیهسازی دینامیک مولکولی با پتانسیلهای یادگیری ماشین (Machine Learning Force Fields)
- ۱۰. ایده ۹: پلیفارماکولوژی هوشمند و مهار چندهدفه شبکهای در سرطانها و بیماریهای نورودژنراتیو
- ۱۱. ایده ۱۰: غربالگری مجازی فوقعظیم با محاسبات هیبریدی کوانتوم-هوش مصنوعی (Quantum-AI)
- ۱۲. جدول مقایسهای پیشرفتهترین فریمورکها و ابزارهای هوش مصنوعی ۲۰۲۶
- ۱۳. چالشهای آزمایشگاهی، سنتزپذیری و اعتبارسنجی مرطوب (Wet-Lab Validation)
- ۱۴. نقشه راه یادگیری و مهارتهای ضروری متخصص طراحی دارو در عصر هوش مصنوعی
- ۱۵. سوالات متداول در زمینه هوش مصنوعی و طراحی دارو
- ۱۶. دوره جامع صفر تا صد طراحی دارو حامی صنعت (فرصت ورود حرفهای به بازار کار و چاپ مقاله ISI)
۱. مقایسه متدولوژی سنتی کشف دارو در برابر طراحی دارو با هوش مصنوعی ۲۰۲۶
برای درک عمق تحولی که در حال وقوع است، باید نگاهی به تفاوت بنیادین میان دو رویکرد بیاندازیم. در مدل سنتی، فرآیند طراحی بر اساس غربالگری فیزیکی یا مجازی کتابخانههای شیمیایی موجود انجام میشد. اگر مولکولی مناسب در پایگاههای داده وجود نداشت، دانشمندان ناچار بودند با ایجاد تغییرات اندک بر روی ساختارهای شناختهشده (Scaffold Hopping)، به بهینهسازی دستی بپردازند. اما در رویکرد هوش مصنوعی زایشی سال ۲۰۲۶، الگوریتم مستقیماً بر اساس مشخصات الکترواستاتیک و هندسی پاکت پیوندی پروتئین هدف، مولکول جدید را از پایه خلق میکند.
۲. ایده ۱: طراحی دونوو مولکولهای کوچک با مدلهای انتشار ۳بعدی Target-Aware Diffusion
یکی از بزرگترین دستاوردهای سالهای ۲۰۲۵ و ۲۰۲۶ در زمینه کموانفورماتیک ساختاری، به کارگیری مدلهای انتشار هماهنگ متقارن (SE(3)-Equivariant Diffusion Models) برای تولید مستقیم لیگاند در داخل حفره اتصال پروتئین (Target-Aware Generation) است. در روشهای قدیمیتر مبتنی بر مدلهای زبانی مانند SMILES یا GANها، خروجی مدل تنها یک توالی متنی یا گراف دو بعدی از مولکول بود. سپس شیمیدان مجبور بود این ساختار را به فرم ۳ بعدی درآورده و آن را در پاکت هدف داک کند که در بیش از ۷۰ درصد موارد، مولکول به دلیل عدم تقارن فضایی یا ممانعتهای فضایی (Steric Clashing) توانایی قرارگیری درون پاکت را نداشت.
مدلهای نوین انتشاری نظیر TargetDiff، DiffSBDD و توسعههای ارتقایافته آنها در سال ۲۰۲۶، فرآیند را کاملاً معکوس کردهاند. در این سیستمها، ابتدا اتمهای پاکت پروتئینی ثابت در نظر گرفته شده و فضایی از نویز خالص سهبعدی به صورت ابری از دانسیتههای احتمالی در داخل حفره ایجاد میشود. سپس شبکه عصبی از طریق فرآیند معکوس انتشار (Reverse Diffusion Process)، در هر گام نویز را کاهش داده و موقعیت سهبعدی دقیق اتمهای کربن، نیتروژن، اکسیژن و حلقههای آروماتیک را به گونهای قرار میدهد که پیوندهای هیدروژنی، برهمکنشهای الکترواستاتیک، دافعه واندروالسی و پیوندهای پی-استکینگ در مطلوبترین حالت ترمودینامیکی تشکیل شوند.
- نرخ موفقیت بالا در اتصال: لیگاند تولیدشده از ثانیه اول دقیقاً برای همان حفره کونفورماسیونی متولد شده است.
- نوآوری شیمیایی (Scaffold Novelty): این مدلها قادرند اسکلتهای شیمیایی کاملاً نوین خلق کنند که هرگز در پایگاههایی مانند PubChem یا ChEMBL ثبت نشدهاند و بدین ترتیب فرصتی بینظیر برای ثبت اختراع (Patent) دارویی بینالمللی ایجاد میکنند.
- کنترل وزن مولکولی و بار الکتریکی: امکان تعیین محدودیتهای فارماکوپهای (مانند قوانین پنجگانه لیپینسکی یا قواعد Veber) در فرآیند انتشار جهت اطمینان از دارومانند بودن (Drug-likeness) ساختار.
۳. ایده ۲: پیشبینی دقیق برهمکنشهای چندگانه با AlphaFold 3 و کمپلکسهای اتمی
انتشار رسمی و دسترسی به نتایج مدل AlphaFold 3 توسط شرکت DeepMind و ساختارهای معادل جامعه متنباز مانند RoseTTAFold All-Atom نقطه عطفی تاریخی در سال ۲۰۲۶ است. در نسخههای پیشین (AlphaFold 2)، مدل تنها به پیشبینی تاخوردگی زنجیره پلیپپتیدی تکپروتئینی محدود بود. اما داروها در محیط سلولی با پروتئینهای خالص برهمکنش ندارند؛ دارو با یک سیستم دینامیک شامل کوفاکتورها، یونهای فلزی کاتالیزوری (مانند روی، منیزیم، آهن)، زنجیرههای قندی (Glycosylation)، مولکولهای آب ساختاری، لیپیدهای غشایی و حتی اسیدهای نوکلئیک احاطه شده است.
معماری ارتقایافته AlphaFold 3 از یک ماژول Pairformer و ماژول انتشار ۳بعدی تماماتمی (All-Atom Diffusion Module) بهره میبرد که اجازه میدهد پروتئین، یونها، مولکول لیگاند سنتزی و اسیدهای نوکلئیک به صورت یکجا و همزمان مدلسازی شوند. این پیشرفت انقلابی چند معضل قدیمی را حل کرده است:
- حذف خطای داکینگ صلب: پروتئین دیگر به صورت یک مجسمه سنگی فرض نمیشود؛ زنجیرههای جانبی اسیدهای آمینه در پاسخ به حضور بار الکتریکی لیگاند تغییر کونفورماسیون میدهند (Induced-Fit Mechanism).
- مدلسازی دقیق متالوآنزیمها (Metalloenzymes): بیش از یکسوم تمامی اهداف دارویی حاوی یونهای فلزی در جایگاه فعال خود هستند که روشهای داکینگ کلاسیک به دلیل پیچیدگیهای کوانتومی در مدلسازی آنها شکست میخوردند؛ اما AlphaFold 3 به زیبایی هندسه هماهنگی فلزی را حل میکند.
- کاهش زمان شناسایی کمپلکس از چند ماه بلورشناسی اشعه ایکس به چند دقیقه پردازش ابری: این امر به بیوانفورماتیکدانان اجازه میدهد صدها واریانت جهشیافته بیماریزا را در برابر مولکول دارویی ارزیابی کنند.
۴. ایده ۳: توسعه داروهای تخریبگر هدفمند (PROTACs و Molecular Glues) با شبکههای عصبی گراف
در فارماکولوژی سنتی، یک داروی مولکول کوچک معمولاً به عنوان یک «مهارکننده اشغالکننده» (Occupancy-driven pharmacology) عمل میکند؛ یعنی با اتصال به پاکت فعال آنزیم، فعالیت کاتالیزوری آن را مسدود میسازد. اما فاجعه اینجاست که بیش از ۸۵ درصد از کل پروتئینهای دخیل در بیماریهای انسانی، فاقد هرگونه جایگاه فعال کاتالیزوری واضح هستند و اصطلاحاً پروتئینهای غیرقابل مهار (Undruggable Targets) نامیده میشوند (نظیر عوامل رونویسی مانند MYC، پروتئینهای داربستی و فاکتورهای انکوژنیک).
انقلاب دارویی سال ۲۰۲۶ به سمت تخریب هدفمند پروتئین (Targeted Protein Degradation یا TPD) از طریق مولکولهای کایمریک PROTAC و چسبهای مولکولی (Molecular Glues) گرایش پیدا کرده است. یک مولکول PROTAC از سه جزء تشکیل شده است: یک سر متصلشونده به پروتئین بیماریزا، یک سر متصلشونده به آنزیم لیگاز E3، و یک زنجیره پیونددهنده (Linker). هنگامی که این مولکول هر دو پروتئین را به یکدیگر متصل میکند، یک کمپلکس سهتایی (Ternary Complex) شکل میگیرد که موجب پلییوبیکوئیتینهشدن پروتئین هدف و هدایت آن به سمت دستگاه پروتئازوم سلولی جهت تخریب کامل فیزیکی میشود!
چالش بزرگ در اینجا طراحی فیزیکی «لینکر» و جهتگیری فضایی دو پروتئین است. استفاده از شبکههای عصبی گراف رابطهای (Relational Graph Neural Networks – RGNNs) و پیشبینیکنندههای کمپلکس ترنری مبتنی بر یادگیری ماشین نظیر Alpha-Fold Multimer و Proset توانسته است پیشبینی پایداری ترمودینامیکی کمپلکس سهتایی و طول بهینه لینکر را با دقت شگفتآور انجام دهد. این امر راه را برای درمان قطعی سرطانهای مقاوم و بیماریهای خودایمنی هموار ساخته است.
۵. ایده ۴: مدلهای زبانی شیمیایی (Chemical LLMs) و آزمایشگاههای شیمی خودران رباتیک
یکی از پیشروترین مفاهیم در مقالات علمی ۲۰۲۶، ظهور آزمایشگاههای خودران بیوشیمی (Autonomous Self-Driving Labs) است. در گذشته، بزرگترین گرهگاه در پروژههای طراحی دارو توسط هوش مصنوعی، مرحله «سنتز آزمایشگاهی» بود. کامپیوترها مولکولهای بینظیری با انطباق عالی طراحی میکردند، اما وقتی طرح به شیمیدان سنتزی ارائه میشد، او اعلام میکرد که سنتز این مولکول در عمل غیرممکن است یا نیازمند ۶ ماه واکنشهای پیچیده و پرخطر میباشد!
در سال ۲۰۲۶، تلفیق مدلهای زبانی بزرگ شیمیایی نظیر ChemCrow و Mol-LLM با موتورهای رتروسنتز پیشرفته (مانند AiZynthFinder و ASKCOS) این مشکل را به طور اساسی ریشهکن کرده است. این ایجنتهای هوش مصنوعی شیمیایی:
- مولکول پیشنهادی را بررسی کرده و درخت مسیر سنتز معکوس (Retrosynthesis Tree) آن را بر اساس واکنشگرهای شیمیایی تجاری موجود در انبار استخراج میکنند.
- بهینهترین شرایط واکنش (دما، کاتالیزور، حلال و زمان واکنش) را پیشبینی مینمایند.
- دستورالعملهای کدنویسیشده را مستقیماً به ایستگاههای رباتیک مایعریزی و رآکتورهای میکروفلوئیدیک خودکار ارسال میکنند.
- ربات واکنش را سنتز کرده، خروجی را با کروماتوگرافی مایع و طیفسنجی جرمی (LC-MS) آنالیز میکند و دادههای حاصل از فعالیت بیولوژیکی واقعی را مجدداً به عنوان بازخورد (Reinforcement Learning from Wet-Lab Feedback) به الگوریتم هوش مصنوعی بازمیگرداند. این چرخه بسته طراحی-ساخت-تست-تحلیل (DMTA Cycle) سرعت پروژهها را تا ۵۰ برابر افزایش داده است!
۶. ایده ۵: هدفگیری ساختارهای سهبعدی RNAهای غیرکدکننده (RNA-Targeting) با یادگیری عمیق
بیش از ۹۸ درصد از ژنوم انسان که رونویسی میشود، هرگز به پروتئین ترجمه نمیگردد و به شکل RNAهای غیرکدکننده (مانند lncRNAها و microRNAها) در سلول نقشآفرینی میکند. این مولکولهای RNA در ایجاد و پیشرفت بیماریهای سرطانی، ناهنجاریهای قلبی-عروقی و اختلالات نورودژنراتیو نقش کلیدی دارند، اما برای سالها دارورسانی به آنها محدود به فناوریهای پرهزینه الیگونوکلئوتیدی و siRNA بود که با موانع جدی پایداری و عبور از سد سلولی روبرو بودند.
ایده انقلابی ۲۰۲۶ استفاده از هوش مصنوعی برای طراحی مولکولهای کوچک خوراکی با قابلیت اتصال مستقیم به پاکتهای سهبعدی RNA است. الگوریتمهای یادگیری عمیق ساختاری نظیر ARES و معماریهای مدلسازی RNA در سالهای ۲۰۲۵ و ۲۰۲۶ توانستهاند تاخوردگی سهبعدی موتیفهای RNA (شامل حلقهها، بالجها و پیوندهای کاذب Pseudoknots) را پیشبینی کنند. بدین ترتیب، شیمیدانان دارویی میتوانند مولکولهای کوچکی طراحی کنند که با مداخله در ساختار فضایی RNA، مانع از رونویسی یا اتصال پروتئینهای بیماریزا به آن شوند؛ گامی که دامنه اهداف دارویی بشر را به ده برابر گسترش داده است.
۷. ایده ۶: پیشبینی چندوظیفهای خواص فارماکوکینتیک و پروفایل سمیت (ADMET Transfer Learning)
یک ضربالمثل مشهور در صنعت داروسازی میگوید: «کشتن یک سلول سرطانی در پتریدیش آسان است، هنر واقعی این است که کل ارگانیسم بیمار را نکشیم!» بیشتر داروهای شکستخورده نه به دلیل عدم تمایل به هدف، بلکه به خاطر رفتار نامناسب در بدن انسان از گردونه رقابت خارج میشوند. این رفتار شامل پنج فاکتور حیاتی جذب (Absorption)، توزیع (Distribution)، متابولیسم (Metabolism)، دفع (Excretion) و سمیت (Toxicity) یا همان ADMET است.
پیش از این، پیشبینی این خواص به صورت ارزیابیهای تکبعدی و غیردقیق انجام میشد. اما مقالات منتشرشده در ژورنالهای معتبر ۲۰۲۵ و ۲۰۲۶ نشان میدهند که استفاده از یادگیری انتقالی چندوظیفهای (Multi-Task Transfer Learning) و مدلهای پیشآموزشدیده بر روی صدها هزار آزمایش زیستی (مانند پایگاههای TDC – Therapeutics Data Commons) تحولی عظیم ایجاد کرده است. در این متدولوژی:
- مدل به طور همزمان توانایی عبور از سد خونی-مغزی (Blood-Brain Barrier)، اتصال به پروتئینهای پلاسما، بازدارندگی آنزیمهای کلیدی کبد (سیتوکرومهای CYP3A4, CYP2D6) و پاکسازی کلیوی را پیشبینی میکند.
- سمیت قلبی مرگبار ناشی از مسدودسازی کانال پتاسیمی hERG که علت اصلی توقف تولید بسیاری از داروها در تاریخ پزشکی بوده است، با دقت بالاتر از ۹۳ درصد پیش از ساخت فیزیکی ترکیب شناسایی میشود.
- هوش مصنوعی در لحظه سنتز مجازی، به عنوان یک غربالگر هوشمند عمل کرده و ترکیباتی را که دارای خواص سمّی هستند، پیش از صرف هزینه فیلتر میکند.
۸. ایده ۷: طراحی واکسنهای نئورآنتیژن شخصیسازیشده و آنتیبادیهای درمانی با Protein LLMs
یکی از درخشانترین کاربردهای هوش مصنوعی در انکولوژی، توسعه پزشکی شخصیسازیشده (Personalized Medicine) است. تومور سرطانی هر بیمار دارای جهشهای ژنتیکی منحصربهفردی است که پروتئینهای جهشیافتهای به نام نئورآنتیژن (Neoantigen) تولید میکنند. اگر سیستم ایمنی بتواند این آنتیژنها را تشخیص دهد، سلولهای T خود بیمار سلولهای سرطانی را نابود خواهند کرد.
با بهکارگیری مدلهای زبانی پروتئین فوقپیشرفته نظیر ESM-3 و ProtGPT2 در سال ۲۰۲۶:
- ژنوم تومور و بافت سالم بیمار با توالییابی نسل جدید (NGS) مقایسه شده و جهشهای سوماتیک در کسری از ثانیه شناسایی میشوند.
- هوش مصنوعی پردازش داخلسلولی پپتیدها و شدت اتصال آنها به مولکولهای آنتیژن لوکوسیت انسانی (HLA / MHC Class I & II) فرد را محاسبه میکند.
- ایمونوژنیکترین اپیتوپها انتخاب شده و توالی بهینه mRNA برای ساخت یک واکسن شخصیسازیشده طراحی میشود که سیستم ایمنی را منحصراً علیه سلولهای سرطانی بیمار تسلیح میکند.
- همچنین در حوزه طراحی آنتیبادیهای مونوکلونال درمانی (mAbs)، هوش مصنوعی حلقههای اتصالدهنده به آنتیژن (CDR-H3 Loops) را طوری بازطراحی میکند که بدون ایجاد پاسخ آلرژیک، بالاترین آفینیتی و حلالیت را ارائه دهند.
۹. ایده ۸: شبیهسازی دینامیک مولکولی با پتانسیلهای یادگیری ماشین (Machine Learning Force Fields)
شبیهسازی دینامیک مولکولی (Molecular Dynamics Simulation – MD) ابزار استاندارد طراحان دارو برای مشاهده رفتار زمانی و حرکات اتمی پروتئین و دارو در محیط آبی بدن است. با این حال، شبیهسازیهای سنتی همواره درگیر یک دوگانه دردناک بودهاند:
- مکانیک کوانتومی (DFT): بینهایت دقیق است زیرا شکست و تشکیل پیوندها و قطبش الکترونی را محاسبه میکند، اما هزینه محاسباتی آن به قدری بالاست که تنها برای چند ده اتم و بازههای زمانی چند پیکوثانیه قابل اجراست.
- میدانهای نیروی کلاسیک (AMBER, CHARMM): سریع هستند اما با تقریبهای نیوتنی کار میکنند و رفتارهای الکترونیکی، جهشهای قطبی و تشکیل پیوندهای موقت را نادیده میگیرند.
در سال ۲۰۲۶، ظهور میدانهای نیروی یادگیری ماشین (MLFFs) نظیر معماریهای MACE، Allegro و NequIP این مانع بنیادین را در هم شکسته است. این شبکهها با یادگیری سطوح انرژی پتانسیل از محاسبات کوانتومی بسیار دقیق، قادرند دقت محاسبات کوانتومی را با سرعت مکانیک کلاسیک ارائه دهند! این امر امکان مشاهده پدیدههای حیاتی مانند مسیرهای آلوستریک پروتئین، فرآیند باز و بسته شدن پاکتهای پنهان (Cryptic Pockets) و فرار یا اتصال دارو در مقیاسهای زمانی میکروثانیهای را با استفاده از GPUهای مدرن فراهم کرده است.
۱۰. ایده ۹: پلیفارماکولوژی هوشمند و مهار چندهدفه شبکهای در سرطانها و بیماریهای پیچیده
فرضیه کلاسیک پائول ارلیش در فارماکولوژی بر مفهوم «گلوله جادویی» (Magic Bullet) استوار بود: یک بیماری = یک هدف بیولوژیکی = یک دارو. اما بیماریهای قرن بیست و یکم نظیر سرطانهای بدخیم، آلزایمر، پارکینسون و دیابت، بیماریهای تکژنی یا تکآنزیمی نیستند. تومورهای سرطانی شبکههای ترارسانی پیام پیچیدهای دارند؛ اگر دارویی فقط مسیر EGFR را مهار کند، سلول سرطانی به سرعت مسیر جبرانی MET یا AXL را فعال کرده و مقاومت دارویی ایجاد میشود. تجویز چند داروی مختلف به بیمار نیز سبب ایجاد بار دارویی شدید، مسمومیت کبدی و تداخلات خطرناک میگردد.
راهکار پیشرو در سال ۲۰۲۶، طراحی داروهای تکمولکولی چندهدفه (Multi-Target Polypharmacology) به کمک مدلهای هوش مصنوعی بیولوژی سیستمها (Systems Biology AI) است:
- هوش مصنوعی ابتدا شبکه پروتئین-پروتئین (PPI Network) تومور را تحلیل کرده و گرههای بحرانی را که در صورت مهار همزمان منجر به آپوپتوز سلولی بدون ایجاد مسیر جبرانی میشوند، شناسایی میکند.
- سپس با استفاده از مدلهای بهینهسازی چندمعیاره، مولکول منحصربهفردی طراحی میشود که دارای پروفایل میل ترکیبی گزینششده برای ۲ یا ۳ آنزیم هدف باشد و در عین حال هیچ برهمکنشی با کینازهای سالم بدن نداشته باشد. این رویکرد نرخ بقای بیماران در کارآزماییهای اولیه را به طور چشمگیری ارتقا بخشیده است.
۱۱. ایده ۱۰: غربالگری مجازی فوقعظیم با محاسبات هیبریدی کوانتوم-هوش مصنوعی (Quantum-AI)
اندازه کل «فضای شیمیایی قابل داروشدن» تخمین زده میشود که برابر با ۱۰⁶⁰ مولکول باشد؛ رقمی نجومی که از تعداد اتمهای کل کهکشان راه شیری نیز بیشتر است! حتی با سریعترین کلاسترهای ابری و دیتابیسهای چند میلیارد مولکولی نظیر ZINC20 و Enamine REAL Space (شامل بیش از ۳۰ میلیارد مولکول قابل سنتز بر اساس تقاضا)، غربالگری داکینگ تمام این ترکیبات با روشهای مرسوم دههها زمان میطلبد.
در سال ۲۰۲۶، تلفیق رایانش کوانتومی با الگوریتمهای هوش مصنوعی (Quantum Machine Learning) این غیرممکن را ممکن ساخته است. با پیادهسازی الگوریتمهای بهینهسازی کوانتومی نظیر Variational Quantum Eigensolver (VQE) و Quantum Approximate Optimization Algorithm (QAOA) روی پردازندههای هیبریدی، غربالگری کتابخانههای حاوی ۱۰۰ میلیارد مولکول در کمتر از ۴۸ ساعت انجام میگیرد. مدلهای هوش مصنوعی با فیلتر سریع توپولوژی مولکولها، تنها نویدبخشترین زیرفضاها را به پردازندههای کوانتومی ارسال میکنند تا بالاترین دقت اتصال در جایگاه هدف بدون فوت وقت محاسبه شود.
۱۲. جدول مقایسهای فریمورکها و ابزارهای هوش مصنوعی طراحی دارو در سال ۲۰۲۶
برای محققان، دانشجویان و شرکتهای داروسازی که میخواهند از این فناوریها استفاده کنند، انتخاب ابزار مناسب حیاتی است. در جدول زیر، برترین پلتفرمها و فناوریهای فعال در سال ۲۰۲۶ از نظر کاربرد تخصصی، دقت و ساختار ورودی مقایسه شدهاند:
۱۳. چالشهای آزمایشگاهی، سنتزپذیری و اعتبارسنجی مرطوب (Wet-Lab Validation)
با تمام هیجانی که پیرامون هوش مصنوعی و موفقیتهای محاسباتی آن وجود دارد، جامعه علمی در سال ۲۰۲۶ با دیدگاهی واقعبینانه و مبتنی بر شواهد عمل میکند. هیچ دارویی صرفاً بر اساس خروجی یک الگوریتم پایتون یا نمایش سهبعدی در نرمافزار PyMOL وارد کلینیک نمیشود. چالشهای اصلی پیشروی محققان این حوزه عبارتند از:
- پدیده توهم شیمیایی (Chemical Hallucination): مدلهای زایشی ممکن است مولکولهایی با تقارنهای غیرممکن، اتمهای کربن پنجظرفیتی یا ساختارهایی با انرژی پیوندی ناپایدار تولید کنند. استفاده از فیلترهای پسپردازش سختگیرانه فیزیکی مانند RDKit و بررسی SAscore (Synthetic Accessibility Score) الزامی است.
- کمبود دادههای باکیفیت منفی (Negative Data): بیشتر پایگاههای دادههای زیستی نظیر PDB و ChEMBL حاوی نتایج آزمایشهای موفق هستند و کمتر مقالهای نتایج منفی و مولکولهای ناموفق را ثبت میکند. این عدم تعادل، الگوریتمها را مستعد خطای سوگیری انتخاب (Selection Bias) میسازد.
- پل زدن بین کامپیوتر و لوله آزمایش (In Silico to In Vitro): هنر اصلی یک دانشمند بیوانفورماتیک و طراح دارو در سال ۲۰۲۶ این است که بتواند فرضیه محاسباتی خود را در قالب یک پروپوزال شفاف برای آزمونهای آزمایشگاهی سنجش اتصال (نظیر SPR – Surface Plasmon Resonance یا ITC – Isothermal Titration Calorimetry) طراحی کند.
۱۴. نقشه راه یادگیری و مهارتهای ضروری متخصص طراحی دارو در عصر هوش مصنوعی
اگر دانشجوی داروسازی، بیوتکنولوژی، شیمی، ژنتیک، زیستشناسی سلولی-مولکولی یا مهندسی کامپیوتر و هوش مصنوعی هستید، احتمالاً این سوال اساسی برایتان مطرح است: «چگونه میتوان وارد این بازار کار پرتقاضا، فوقالعاده پولساز و در حال انفجار شد؟»
برای تبدیل شدن به یک متخصص واقعی طراحی دارو که بتواند در شرکتهای داروسازی معتبر استخدام شود، اپلای دانشگاههای برتر دنیا را بگیرد و مقالات ISI با ایمپکت بالا منتشر کند، تسلط بر ۴ ستون اصلی زیر ضرورت دارد:
- پایگاههای داده و کموانفورماتیک ساختاری: توانایی واکشی و آمادهسازی ساختارهای بلوری از Protein Data Bank (PDB)، کار با شناسه پایگاههای ChEMBL, PubChem, DrugBank و ویرایش لیگاندها.
- تسلط بر نرمافزارهای تجسم و آنالیز سهبعدی: کار با نرمافزارهای استاندارد صنعتی نظیر PyMOL برای مشاهده برهمکنشهای اتمی، اندازهگیری فواصل پیوندی، بررسی زوایای فضایی و استخراج نقشههای فارماکوفوری (Pharmacophore Modeling).
- روشهای استاندارد مدلسازی: یادگیری فرآیند آمادهسازی پروتئین (Protein Preparation)، بهینهسازی بار الکتریکی با Gasteiger یا Kollman، داکینگ مولکولی (Molecular Docking)، شبیهسازی دینامیک مولکولی (MD) و پیشبینی خواص فارماکوکینتیک QSAR.
- مهندسی و تحلیل آماری با R و پایتون: استفاده از بستههای کموانفورماتیک برای غربالگری خودکار صدها کاندیدای دارویی و استخراج نتایج آماری دقیق مناسب برای ژورنالهای پژوهشی معتبر.
۱۵. سوالات متداول در زمینه هوش مصنوعی و طراحی دارو
آیا هوش مصنوعی جایگزین شیمیدانان و داروسازان خواهد شد؟
خیر؛ همانطور که متخصصان پیشرو در سال ۲۰۲۶ تأکید میکنند: «هوش مصنوعی جایگزین داروسازان نمیشود، اما داروسازان و محققانی که از هوش مصنوعی استفاده میکنند، بدون شک جایگزین کسانی خواهند شد که از آن استفاده نمیکنند!» هوش مصنوعی ابزاری خارقالعاده برای تسریع اکتشاف است، اما هدایت فرضیهها و اعتبارسنجی بیولوژیکی همواره نیازمند درک عمیق دانشمندان است.
آیا برای یادگیری طراحی دارو باید پیشزمینه برنامهنویسی قوی داشته باشیم؟
به هیچ وجه. امروزه اکثر نرمافزارهای پایهای طراحی دارو (نظیر PyMOL و وبسرورهای AlphaFold 3 و ابزارهای فارماکوفور) دارای رابطهای کاربری گرافیکی قدرتمندی هستند. مفاهیم کدنویسی بیوانفورماتیک با زبانهایی نظیر پایتون و R نیز به صورت گامبهگام و از صفر برای اهداف تحلیل دارویی آموزش داده میشوند، بنابراین حتی دانشجویان با پیشزمینه زیستشناسی یا پزشکی محض نیز به راحتی مسلط میشوند.
آیا نتایج به دست آمده از طراحی داروی محاسباتی قابلیت چاپ در مقالات ISI را دارد؟
بله، کاملاً. ژورنالهای معتبر بینالمللی متعددی (از جمله در انتشارات Elsevier، Springer Nature، ACS و Wiley) به صورت ویژه مقالات طراحی محاسباتی دارو (In Silico Drug Design)، غربالگری مجازی، فارماکوفور مدلینگ و داکینگ مولکولی بر روی اهداف بیماریهای نوظهور را به سرعت داوری و منتشر میکنند. این مقالات بالاترین ارزش پژوهشی را برای اخذ فاند و اپلای تحصیلی دارند.
دوره جامع صفر تا صد طراحی دارو | دروازه ورود حرفهای به دنیای بیوانفورماتیک و اکتشاف دارو
اگر میخواهید فراتر از خواندن مقالات تئوری حرکت کنید و خودتان به عنوان یک پژوهشگر پیشگام، ساختارهای دارویی جدید را در رایانه شبیهسازی، مدلسازی و ارزیابی نمایید، «دوره صفر تا صد طراحی دارو حامی صنعت» دقیقاً همان مسیری است که به دنبال آن هستید. این دوره آموزشی بینظیر به گونهای تدوین شده است که حتی بدون داشتن تجربه قبلی، گامبهگام شما را به یک متخصص مسلط بر کموانفورماتیک و اکتشاف دارو تبدیل میکند.
🌟 سرفصلهای تخصصی و کلیدی دوره:
- آشنایی با معتبرترین پایگاههای داده بیماریها، ژنومیک و کموانفورماتیک جهانی
- بیوانفورماتیک ساختاری و مهارت کامل در داکینگ مولکولی پیشرفته (Molecular Docking)
- طراحی دارو بر پایه مدلسازی فارماکوفور (Pharmacophore-based Drug Design)
- تحلیل ارتباط ساختار-فعالیت بیولوژیکی (QSAR) و غربالگری مجازی کتابخانههای شیمیایی
- آشنایی با شبیهسازی دینامیک مولکولی (MD Simulation) و بررسی پایداری کمپلکس
- پیشبینی جامع عوارض جانبی و خواص فیزیکوشیمیایی کاندیدهای دارویی (ADMET Profiling)
- بهینهسازی لیدهای دارویی و طراحی مسیرهای تحقیقاتی تا ثبت اختراع (Patent)
- تحلیل دادههای دارویی با زبان برنامهنویسی R و مفاهیم ماشین لرنینگ
- + کارگاه تخصصی هدیه: آموزش ۰ تا ۱۰۰ کار با نرمافزار قدرتمند PyMOL و تفسیر دادههای ساختاری
💎 مزایای استثنایی شرکت در دوره:
- پشتیبانی مستقیم تا نگارش و چاپ مقالات ISI و ISC: تیم پژوهشی دوره همراه شماست تا پروژه خود را به یک مقاله معتبر علمی تبدیل کنید.
- گواهینامه رسمی انگلیسی دارای کد استعلام بینالمللی: عالیترین برگ برنده برای رزومه اپلای دانشگاهها و مصاحبههای استخدامی.
- ۶ ماه پشتیبانی روزانه و پاسخگویی به سوالات علمی: با حضور ۵ پشتیبان تخصصی و ارتباط مستقیم با مدرس دوره.
- معرفی دانشجویان برتر به مصاحبه استخدامی: دریافت توصیهنامه رسمی از شرکت تخصصی حامی صنعت برای کارخانجات داروسازی و مراکز R&D.
👈 مشاهده سرفصلها و ثبتنام در دوره صفر تا صد طراحی دارو
دسترسی آنی به محتوای آموزشی بلافاصله پس از ثبتنام + پشتیبانی فعال علمی
هر قسط 54.750 تومانهر قسط 54.750 تومان•خرید قسطی با تربپی بدون کارمزد
“تسلط به برنامهنویسی پایتون با هوش مصنوعی: آموزش کدنویسی هوشمند با ChatGPT”
"تسلط به برنامهنویسی پایتون با هوش مصنوعی: آموزش کدنویسی هوشمند با ChatGPT"
"با شرکت در این دوره جامع و کاربردی، به راحتی مهارتهای برنامهنویسی پایتون را از سطح مبتدی تا پیشرفته با کمک هوش مصنوعی ChatGPT بیاموزید. این دوره، با بیش از 6 ساعت محتوای آموزشی، شما را قادر میسازد تا به سرعت الگوریتمهای پیچیده را درک کرده و اپلیکیشنهای هوشمند ایجاد کنید. مناسب برای تمامی سطوح با زیرنویس فارسی حرفهای و امکان دانلود و تماشای آنلاین."
ویژگیهای کلیدی:
بدون نیاز به تجربه قبلی برنامهنویسی
زیرنویس فارسی با ترجمه حرفهای
۳۰ ٪ تخفیف ویژه برای دانشجویان و دانش آموزان